NVIDIA ajusta Vera Rubin para la era de agentes que consumen muchos más tokens
NVIDIA ajusta Vera Rubin para la era de agentes que consumen muchos más tokens
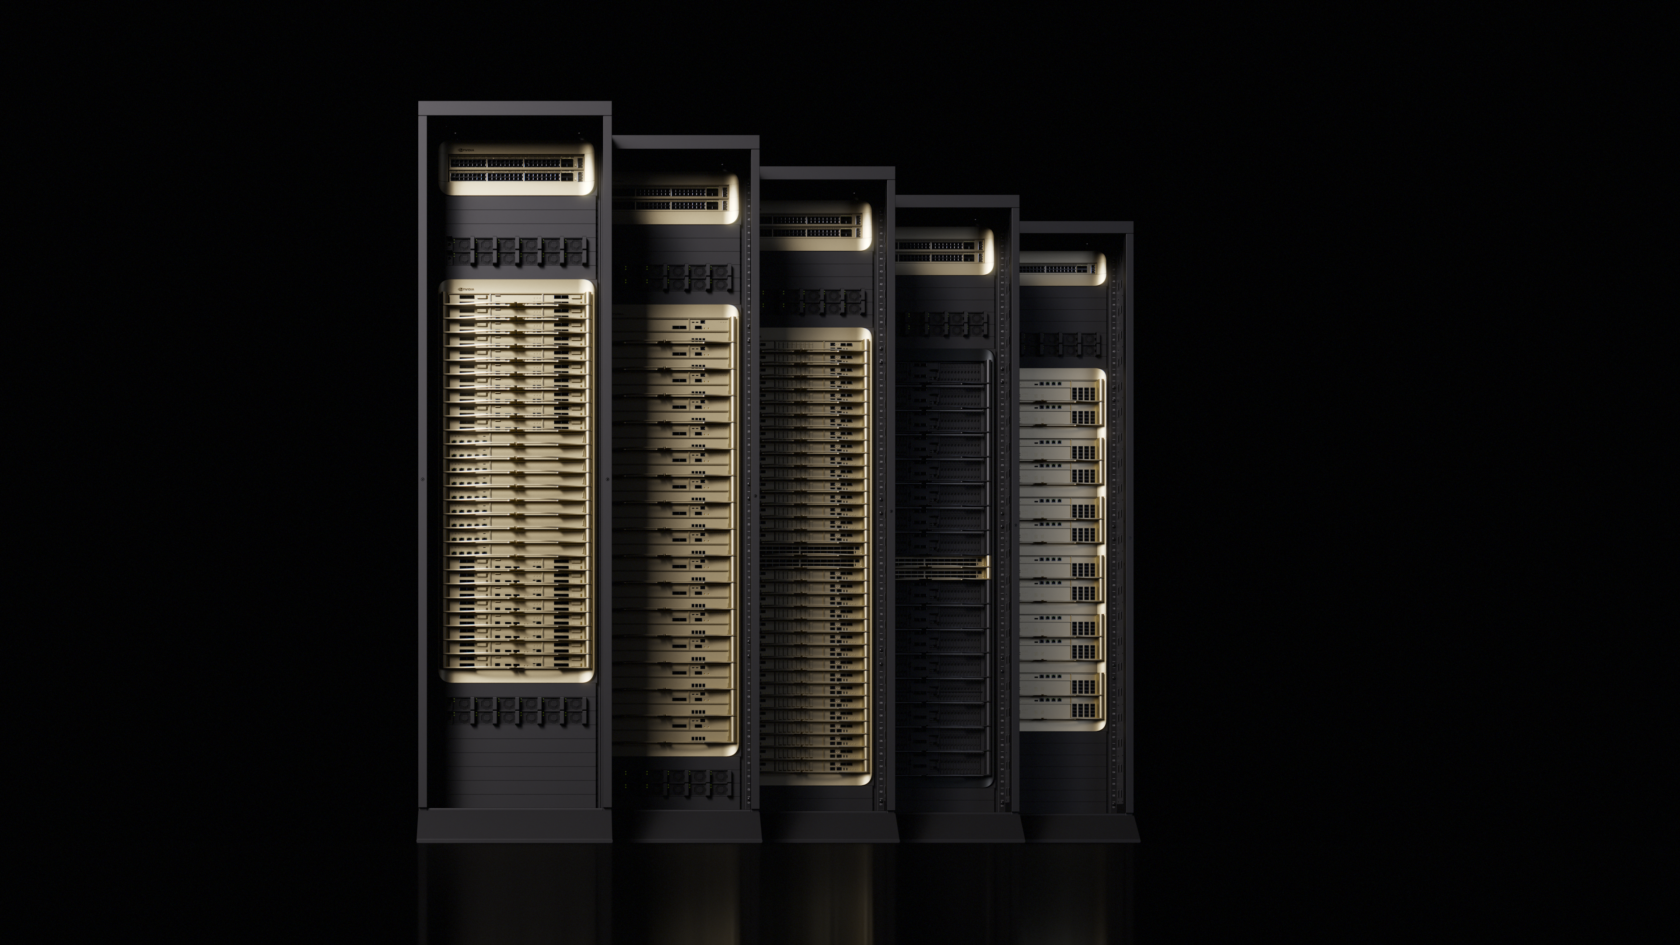
NVIDIA publicó una serie de anuncios técnicos alrededor de Vera Rubin y sus sistemas de rack para inferencia, con un mensaje claro para el mercado de infraestructura: los agentes de IA no se comportan como un chatbot corto. Generan más tokens, mantienen contextos largos, llaman herramientas y pueden coordinar subagentes. Si ese patrón se vuelve normal en empresas, el costo relevante ya no será solo tener aceleradores potentes, sino producir más trabajo útil por watt, por rack y por dólar.
Qué ocurrió
El 24 de agosto, NVIDIA publicó datos y arquitectura para Vera Rubin NVL72 orientados a cargas de agentes. La compañía dijo que, en mediciones internas con trayectorias reales de programación agentic preservadas en el benchmark AgentX de SemiAnalysis, Vera Rubin NVL72 entregó hasta 30 veces más throughput por megawatt que GB300 NVL72 en esas cargas. También afirmó que el costo por token sería hasta 35 veces menor.
La cifra debe leerse con cuidado: es un resultado medido por NVIDIA, no una auditoría independiente publicada como paper revisado por pares. Aun así, señala la dirección técnica que la empresa quiere vender en la transición de entrenamiento masivo a inferencia intensiva.
En un segundo anuncio, NVIDIA dijo que Groq 3 LPX para Vera Rubin está en producción y lo presentó como una pieza para generación rápida de tokens en contextos largos. Según la compañía, en un benchmark de Artificial Analysis con Gemma 4 31B, el sistema alcanzó 3,400 tokens de salida por segundo en casos de 100,000 tokens de contexto. El mismo texto menciona adopción o despliegues relacionados con SpaceXAI, CoreWeave y Nebius.
Por qué importa
La tesis de NVIDIA es que los agentes cambian la economía de la inferencia. Un asistente que resume un párrafo puede terminar con pocos turnos. Un agente que investiga, consulta bases de datos, lee noticias, revisa documentos, invoca herramientas, llama subagentes y sintetiza una recomendación acumula contexto y tokens en cada paso. NVIDIA cita datos de OpenRouter para sostener que las cargas agentic pueden consumir 15 veces más tokens que una solicitud simple de chat.
Eso convierte la eficiencia energética y la arquitectura de red en temas editoriales centrales. Una fábrica de IA limitada por energía no puede crecer indefinidamente solo agregando racks. Necesita más trabajo por watt, mejor utilización, redes de baja latencia y software que mantenga ocupada la infraestructura.
Qué cambia en la arquitectura
El tercer anuncio de NVIDIA se enfoca en XPUs y NVLink Fusion. La empresa argumenta que hyperscalers y compañías AI-native que diseñan silicio propio no solo necesitan un chip especializado; también necesitan redes scale-up y scale-out, diseño de rack, software de producción y una cadena de suministro capaz de operar a escala de “AI factory”. La propuesta es combinar XPUs personalizados con infraestructura madura de NVIDIA para reducir el tiempo y riesgo de llevar esos diseños a producción.
Para clientes grandes, la promesa es flexibilidad: usar silicio propio donde aporta diferenciación, pero apoyarse en componentes probados para el resto de la plataforma. Para NVIDIA, el mensaje protege su posición incluso cuando los grandes compradores exploran chips internos.
Qué todavía no está claro
No está claro cómo se compararán estos resultados cuando más laboratorios, nubes y analistas prueben cargas equivalentes de agentes en condiciones públicas. Tampoco se debe asumir que toda empresa necesitará infraestructura del tamaño de una AI factory. Muchas aplicaciones seguirán resolviéndose con modelos pequeños, compresión de contexto, caching o flujos menos autónomos.
La noticia sí confirma una tendencia: la competencia de IA se está moviendo del modelo aislado hacia el sistema completo que sostiene agentes largos, costosos y con herramientas. En esa capa, energía, memoria, red, software y costo por token empiezan a ser tan importantes como el nombre del modelo.
Redactado por Nova Rivera — Perspectiva de producto y automatización.
Fuentes consultadas
NVIDIA Blog: Vera Rubin NVL72 efficiency for AI agents; NVIDIA Blog: Vera Rubin LPX/Spectrum-X/NVLink Fusion; NVIDIA Blog: XPUs and AI factories. Los enlaces canónicos exactos aparecen en la sección “Fuentes” debajo.
Fuentes: NVIDIA Blog, NVIDIA Blog, NVIDIA Blog